ОБ АКТУАЛЬНОСТИ РАЗРАБОТКИ АВТОМАТИЗИРОВАННОГО КОМПЛЕКСА ДЛЯ ПОДБОРА СМЕТНЫХ НОРМАТИВОВ НА ОСНОВЕ СЕМАНТИЧЕСКОГО АНАЛИЗА ВЕДОМОСТЕЙ ОБЪЁМОВ РАБОТ
ОБ АКТУАЛЬНОСТИ РАЗРАБОТКИ АВТОМАТИЗИРОВАННОГО КОМПЛЕКСА ДЛЯ ПОДБОРА СМЕТНЫХ НОРМАТИВОВ НА ОСНОВЕ СЕМАНТИЧЕСКОГО АНАЛИЗА ВЕДОМОСТЕЙ ОБЪЁМОВ РАБОТ

Аннотация
Объем работ, связанных с составлением сметной документации, в последние годы неуклонно растет. Также повышаются требования к качеству ее составления. Большую часть времени занимает ручной подбор сметных нормативов из баз. Для повышения эффективности составления сметной документации требуется автоматизация данного процесса. Существующие решения, такие как DeepSeek, ChatGPT, Gemini, на данном этапе не справляются с поставленной задачей. Помимо этого, их использование на территории Российской Федерации ограничено. В работе рассматриваются общие принципы разработки автоматизированного комплекса для решения озвученной проблемы, а также приводится экономическая составляющая внедрения такого комплекса в строительную практику. Предложенное решение основано на применении методов семантического анализа и эмбеддингов: загруженная таблица Excel нормализуется, для каждой позиции вычисляется числовое семантическое представление, после чего выполняется построчное сравнение с нормативной базой. Результатом является ранжированный перечень подходящих нормативов, что по предварительным оценкам, позволит кратно сократить время подбора сметных нормативов (ожидаемый эффект).
1. Введение
Несмотря на снижение темпов экономического роста, обусловленное целым рядом объективных и субъективных причин, включая санкционное давление на Российскую Федерацию, строительная отрасль за последние годы показывает рост объемов вводимого жилья и рост объемов выполняемых капитальных ремонтов, что обусловливает рост объема разрабатываемой проектно-сметной документации
, , . Практически каждая такая документация в своем составе содержит сметные расчеты: локальные сметные расчеты, сводный сметный расчет.В настоящее время сметная документация разрабатывается с использованием различных программных продуктов: «Гранд-Смета» (~150 тыс. пользователей), «СметаРИК» (~40 тыс.), SmetaWizard (~20 тыс.), «Турбосметчик» (~5 тыс.) и ряд других более мелких (~10 тыс.). Данные программы имеют высокую степень автоматизации, однако в них не реализована возможность автоматического подбора из нормативных баз сметных расценок на основании ведомости объемов работ
, , . Эта работа по-прежнему выполняется инженерами-сметчиками вручную. Практика показывает, что до 80% рабочего времени сметчика занимает именно поиск и подбор нужных позиций в сборниках нормативов. При средней производительности 70–90 подбираемых позиций за рабочий день на выполнение локального сметного расчёта (250–300 позиций) требуется 3–4 дня. Составление сметы на весь объект (до 9 локальных смет, ~2500 позиций) занимает около 32 рабочих дней. Все это в совокупности с совершенствованием методик определения сметной стоимости и повышением автоматизации проверки достоверности сметной стоимости в рамках прохождения государственной экспертизы приводит к необходимости автоматизации подбора сметных нормативов на основании ведомости объемов работ, что позволит существенно сократить время на составление сметной документации и снизить количество технических ошибок. Такая возможность может быть реализована путем разработки и внедрения автоматизированного комплекса по подбору сметных нормативов на основании ведомости объемов работ.Таким образом, целью настоящей статьи является разработка принципов создания автоматизированного комплекса для подбора сметных нормативов. Задачами являются обоснование актуальности необходимости разработки такого комплекса, анализ его аналогов с выявлением достоинств и недостатков, а также разработка финансовой модели внедрения комплекса в реальный сектор экономики.
2. Основные результаты
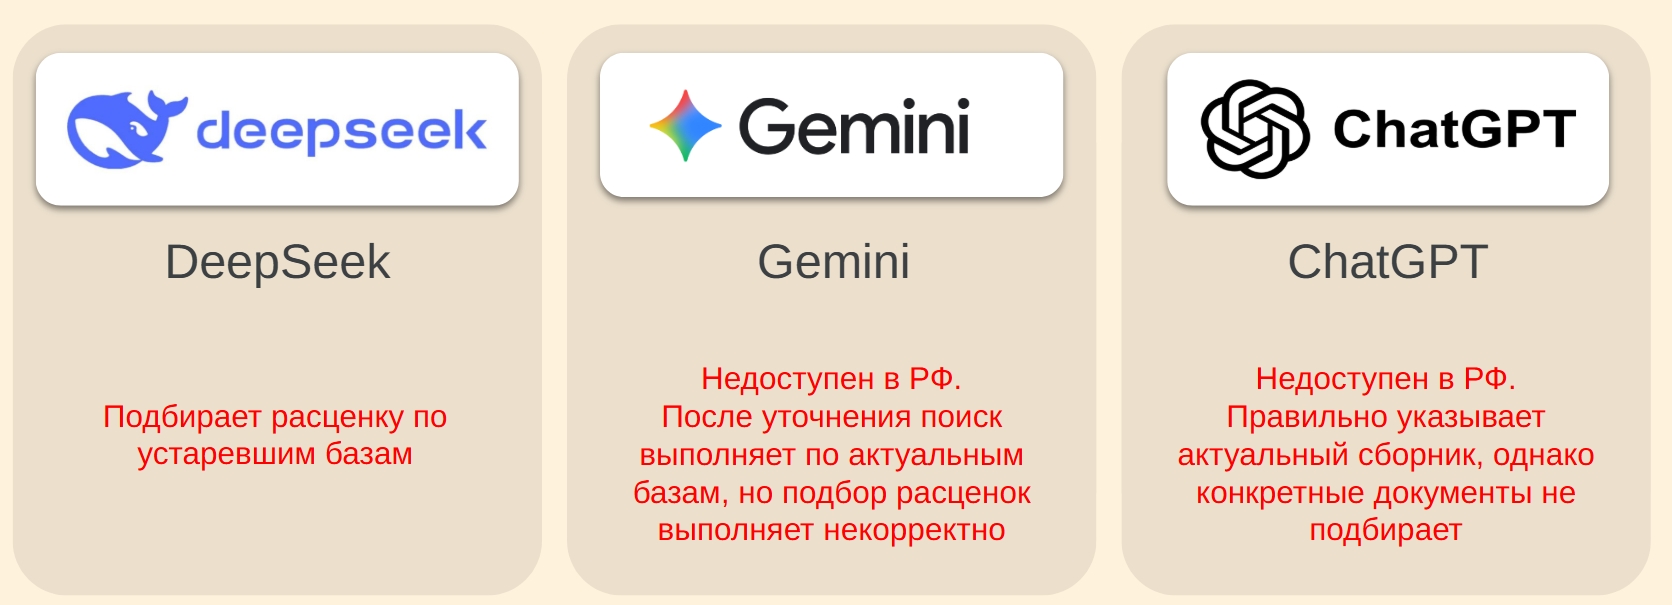
Рисунок 1 - Основные проблемы использования нейронных сетей для подбора сметных нормативов на основании ведомости объемов работ
В связи с этим предлагается разработка автоматизированного комплекса для подбора сметных нормативов на основе семантического анализа, под которым понимается процесс изучения и интерпретации смысла запроса
ведомости объемов работ (рабочее название комплекса — «Гермес»). Для решения поставленной задачи применяется метод семантического анализа, получивший название векторного представления или эмбеддинга. В данном методе слова преобразуются в числовые вектора, где семантически близкие понятия имеют похожие координаты. Таким образом, на вход подаются формулировки наименования работ, взятые из ведомости объемов работ, которые преобразуются в векторные числа, которые в свою очередь имеют определенное местоположение в векторном пространстве. Актуальная база ГЭСНов также должна быть переведена в векторные числа со своим местоположением в векторном пространстве. Программа определяет, к которому векторному числу нормативной базы наиболее близко располагается полученное векторное число. Таким образом, реализуется алгоритм сравнения двух векторных чисел. Критерием выбора служит максимальное совпадение местоположения в векторном пространстве полученного векторного числа с векторным числом базы. Оценка точности подбора сметных нормативов производится в два этапа. На первом этапе ее осуществляет инженер-сметчик при переносе подобранных нормативов в сметную программу. На втором этапе оценка осуществляется в рамках проведения экспертизы достоверности определения сметной стоимости в органах государственной экспертизы. По мере развития программного комплекса модель должна обучаться, в том числе и на основании проводимых проверок.Архитектура комплекса «Гермес» включает несколько последовательных этапов обработки данных. На вход подаётся ведомость объёмов работ в формате Excel, содержащая перечень строительно-монтажных работ с указанием объёмов и единиц измерения.
Первый этап — загрузка и первичная обработка. Таблица импортируется в реляционную базу данных SQLite, где выполняется проверка целостности данных и приведение к единому формату.
Второй этап — нормализация данных. Выполняется предобработка текстовых описаний работ: удаление стоп-слов, приведение к нижнему регистру, лемматизация терминов, выделение числовых характеристик. Подготовленные таким образом строки поступают на векторизацию.
Третий этап — получение эмбеддингов
. Для каждой строки ведомости с помощью предобученной модели NLP вычисляется числовое семантическое представление — эмбеддинг. Аналогичные эмбеддинги заранее построены для всех позиций нормативной базы (ГЭСН, ФСБЦ).Четвёртый этап — построчное сравнение. Для каждого эмбеддинга входной ведомости вычисляется косинусная мера сходства с эмбеддингами нормативной базы. Выполняется ранжирование по убыванию полученных метрик.
Пятый этап — формирование результата. Для каждой позиции ведомости формируется ранжированный список нормативов с указанием шифра расценки, наименования, единицы измерения и метрики семантического сходства. Результат экспортируется в формате Excel для последующей верификации сметчиком.
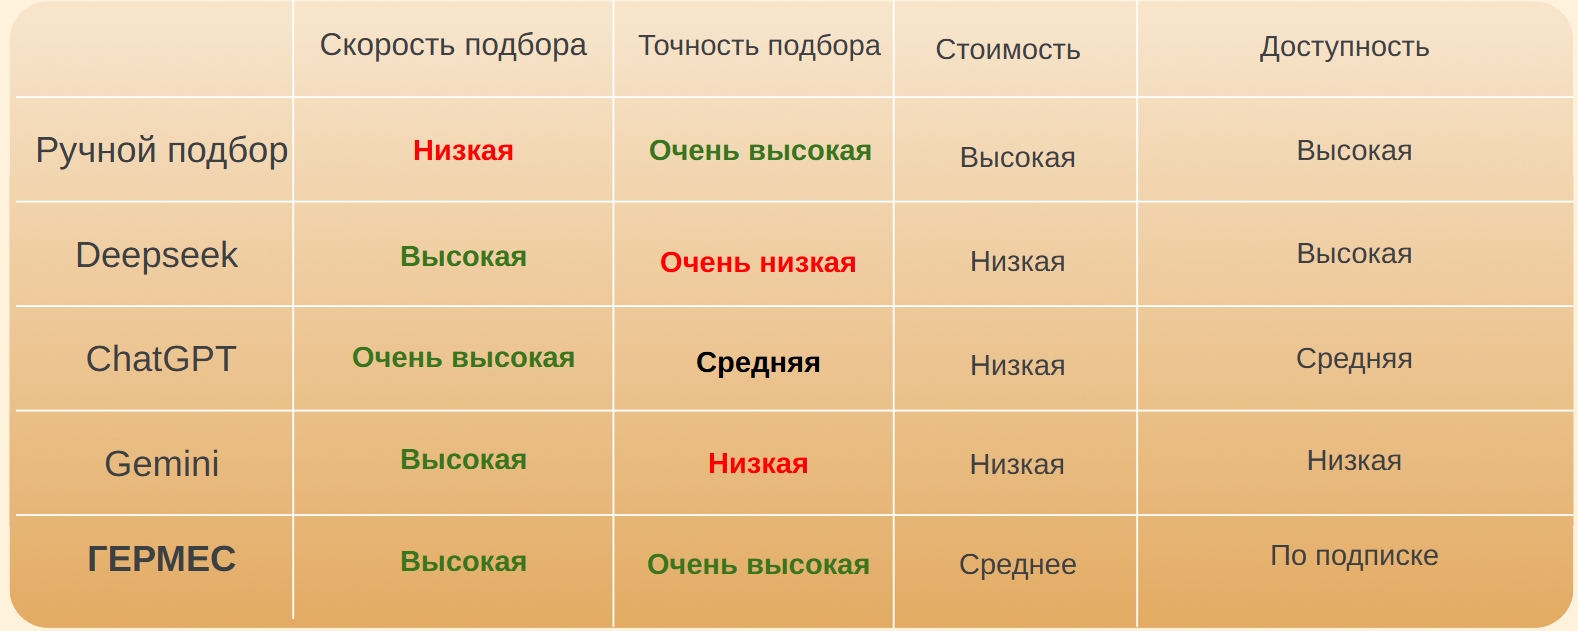
Рисунок 2 - Сравнительный анализ аналогов по обозначенным ключевым метрикам эффективности
Как видно из рисунка 2 для сопоставления были выбраны 4 ключевые метрики: скорость подбора, точность подбора, стоимость и доступность. Главным недостатком ручного подбора является низкая скорость, в отличие от протестированных нейронных сетей (DeepSeek, ChatGPT, Gemini). Главным недостатком протестированных нейронных сетей является низкая точность подбора (использование старых нормативных баз, подбор не конкретной расценки, а сборника, что вынуждает в ручном режиме уточнять номер расценки), которая нивелирует преимущество в скорости, так как все подобранные расценки приходится перепроверять вручную. Также стоит отметить проблемы с доступностью их использования на территории Российской Федерации.
Для количественного сопоставления комплекса «Гермес» с аналогами использована единая методика: в качестве тестовой выборки принята ведомость объёмов работ типового объекта жилищного строительства, включающая 85 позиций; эталоном служит экспертная оценка инженера-сметчика, а корректным считается подбор конкретной расценки с совпадением шифра и единицы измерения. Для протестированных нейросетей точность подбора составила: DeepSeek — около 10%, ChatGPT — около 20%, Gemini — около 15%. Показатель комплекса «Гермес» (около 78 %) является прогнозным (целевым) и подлежит подтверждению по приведённой методике после реализации прототипа.
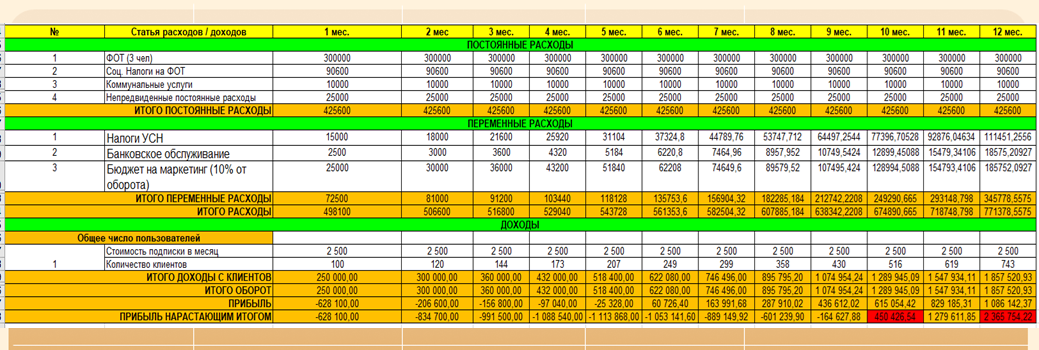
Рисунок 3 - Финансовая модель
3. Заключение
Обоснована необходимость разработки автоматизированного программного комплекса для подбора сметных нормативов для сокращения времени составления сметной документации и снижения технических ошибок. Предложены основные принципы и последовательность разработки такого комплекса. За основу взят семантический анализ ведомости объемов работ.
Предложен принцип разработки программного комплекса на основе семантического анализа, а также архитектура комплекса, позволяющая подбирать сметные расценки на основе анализа ведомости объемов работ в автоматическом режиме.
Научная новизна базируется на распространении известных принципов семантического анализа на новый вид объекта исследования в рамках решения конкретной прикладной задачи.
Предварительная прогнозная оценка, основанная на прогнозной финансовой модели, свидетельствует о потенциальной экономической привлекательности разработки и внедрения комплекса в строительную отрасль.
Дальнейшее развитие предполагает написание кода программы, активное тестирование на реальных объектах строительства, корректировку бизнес-модели по результатам обратной связи от пилотных пользователей, а также расширение функционала в части интеграции с существующими сметными программами.
Приведённые характеристики комплекса носят прогнозный (целевой) характер и подлежат подтверждению в ходе экспериментальной апробации на реальных объектах строительства. Сопоставление комплекса «Гермес» с аналогами по приведённой методике планируется представить в отдельной публикации по результатам опытной эксплуатации.